



Datos de entrenamiento OCR: recibos reales y escritura a mano
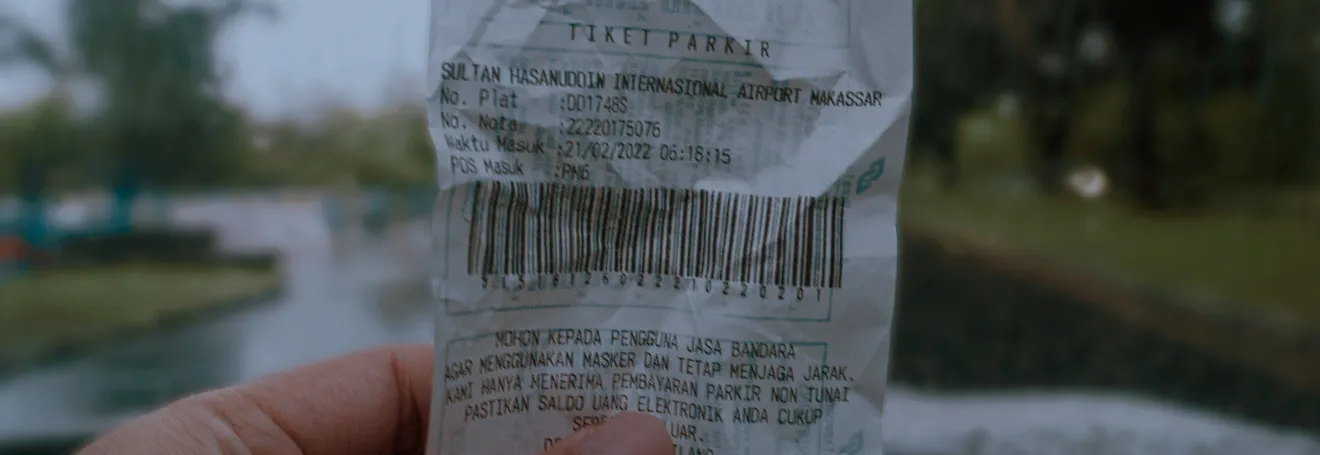
Uno de los datasets de recibos más conocidos, SROIE, de la competición ICDAR 2019, contiene solo 1,000 recibos escaneados. El popular dataset de formularios FUNSD tiene 199 documentos, también escaneados y también en inglés. Mientras tanto, tus usuarios fotografían un recibo arrugado sobre la rodilla bajo la luz de la cocina, en tailandés o en árabe, con un reflejo justo encima del total.
La distancia entre un escaneo limpio y una foto así es una de las principales razones por las que un modelo de OCR con excelentes cifras en benchmarks decepciona en producción. Lo único que la cierra es tu propio dataset de OCR creado a partir de fotos reales. A continuación vemos qué documentos y condiciones de captura necesita, cómo redactar la tarea de recopilación, cómo transcribir el texto, qué hacer con los datos personales y cuánto cuesta todo.
Por qué los modelos de OCR fallan con documentos del mundo real
Un modelo aprende de lo que ha visto. Si sus datos de entrenamiento eran escaneos planos, le cuesta todo lo que no se parezca a uno. En la práctica, hay cinco diferencias de este tipo:
- Fotos en lugar de escaneos. Perspectiva, papel curvado, sombras de la mano, reflejos, desenfoque y la compresión de la cámara de un móvil económico.
- Estado del documento. Papel térmico de recibo descolorido, marcas de dobleces, manchas, sellos sobre el texto.
- Escritura e idioma. Devanagari, árabe de derecha a izquierda, tailandés sin espacios entre palabras, dos idiomas mezclados en una misma línea.
- Maquetación. Los recibos de distintos países y cajas registradoras dan formato diferente a las fechas, los totales y los impuestos; los formularios cambian de una organización a otra.
- Escritura a mano. Cada persona escribe de forma distinta, y lo que importa para que un modelo generalice es la cantidad de personas diferentes que escriben, no solo el número de páginas.
Las distorsiones sintéticas, como la rotación, el ruido y el desenfoque, ayudan, pero solo en parte. No reproducen el papel térmico real, el reflejo real de una lámpara ni la letra de una persona concreta.
Datasets públicos de OCR y lo que les falta
Los datasets públicos son estupendos para empezar y para comparar modelos. Pero todos comparten las mismas limitaciones:
Dataset | Qué contiene | Qué le falta para un producto |
|---|---|---|
1,000 recibos escaneados con etiquetas de campos clave | Fotos de móvil, otros países e idiomas, formatos de recibo actuales | |
1,000 recibos indonesios publicados (800 de entrenamiento, 100 de validación, 100 de prueba) | Otros países y maquetaciones; solo se publicó una parte de los más de 11,000 recibos recopilados | |
199 formularios escaneados en inglés | Volumen, tus plantillas de formulario, otros idiomas | |
Escritura a mano en inglés de 657 personas | Otras escrituras, dígitos y formularios, captura con móvil en lugar de escáner |
El panorama general: escaneos en lugar de fotos, inglés en lugar de idiomas locales y cientos o miles de ejemplos en lugar de la variedad a la que se enfrentará tu producto. Úsalos para el preentrenamiento y las comparaciones de referencia, y recopila tus propios datos para el conjunto de prueba y el ajuste fino. Y revisa la licencia: algunos datasets públicos tienen licencia solo para investigación, no para uso comercial.
Qué documentos y condiciones de captura necesita tu dataset de OCR
La composición del dataset debe reflejar lo que el modelo verá en producción. Cada tipo de documento trae sus propias dificultades típicas:
Tipo de documento | Qué capturar | Errores típicos del modelo |
|---|---|---|
Recibos | Distintas tiendas, países y cajas registradoras, papel térmico descolorido, recibos largos | Confunde el total con el importe del impuesto, pierde líneas en un doblez |
Facturas y albaranes | Tablas, datos de la empresa, sellos y firmas sobre el texto | Rompe la estructura de la tabla, lee un sello como texto |
Formularios y cuestionarios | Campos impresos más entradas a mano, marcas de verificación, texto tachado | No relaciona un campo con su valor, se salta marcas |
Notas manuscritas | Muchas personas distintas, papeles y bolígrafos diferentes, dígitos y abreviaturas | Aprende la letra de unas pocas personas en lugar de generalizar |
Texto en entornos reales | Envases, etiquetas de precio, menús, carteles, pantallas | Pasa por alto texto sobre fondos recargados, confunde tipografías decorativas |
Además del tipo de documento, define una matriz de condiciones de captura: inclinación y perspectiva, papel arrugado o doblado, poca luz, reflejos y sombras, ligero desenfoque, distintos modelos de móvil. Es importante incluir también buenas tomas: si todas las fotos son difíciles, el modelo no aprenderá el caso normal. Tratamos los principios generales de la recopilación de imágenes en nuestro artículo sobre recopilación de datos de imagen para visión artificial.
Nota: recopila los documentos de cada escritura e idioma en los países donde realmente se usan. Un recibo de una tienda de Bangkok y un texto en tailandés impreso en otro país son datos distintos, con otras tipografías, maquetaciones y formatos numéricos. Para eso sirve la segmentación geográfica.
Cuántos datos necesita un modelo de OCR
No hay una cifra universal, porque hoy casi nadie entrena un OCR desde cero. El camino habitual es tomar un modelo existente o una red neuronal multimodal y hacerle un ajuste fino con tus propios documentos. Referencias de la práctica, no reglas estrictas:
- Primero, el conjunto de prueba. Unos cientos de fotos reales con transcripciones exactas muestran lo bien que funciona ya un modelo estándar. A veces basta para descubrir que no necesitas ajuste fino en absoluto.
- Ajuste fino con un tipo de documento. Los equipos suelen empezar con entre unos cientos y mil ejemplos y observan dónde sigue fallando el modelo. Como referencia: la parte pública del dataset CORD tiene solo 800 recibos de entrenamiento, y se usa a menudo para demostrar el ajuste fino de modelos que analizan recibos, por ejemplo en una guía de NVIDIA sobre el ajuste fino del modelo multimodal Gemma.
- Una nueva escritura o letra manuscrita. Necesitas bastantes más datos, y en la escritura a mano la cantidad de personas distintas es crucial. Cien páginas de una sola persona aportan menos que una página de cada una de cien personas.
La calidad en el conjunto de prueba suele medirse con la tasa de error de caracteres (CER) y la tasa de error de palabras (WER). Para documentos como los recibos, es más útil medir la precisión en los campos clave: la fecha, el total, el nombre de la tienda. Un dígito equivocado en el total importa más que una docena de erratas en los nombres de productos.
Por qué crear tu propio dataset de OCR si existen modelos multimodales
Hoy muchos equipos no entrenan ningún OCR: envían las fotos a un modelo multimodal a través de una API, como GPT-4o, Gemini, Qwen-VL y otros. Estos modelos leen una gran variedad de maquetaciones sin ajuste fino, y para algunas tareas es suficiente. Pero aun así necesitas tus propios datos, solo que con otros fines:
- Para comprobar lo fiable que es el modelo con tus documentos. Con el OCR clásico, un error suele verse: un carácter mal leído o que falta. Un modelo multimodal puede devolver un texto verosímil que no está en la imagen, y ese tipo de error en un total no lo detectarás a simple vista. La única forma de saber con qué frecuencia ocurre es un conjunto de prueba con transcripciones de referencia.
- Para elegir proveedor. El mismo conjunto de unos cientos de fotos reales te permite comparar de forma justa varios modelos en precisión, precio por página y velocidad.
- Para hacer ajuste fino de un modelo abierto. Si los documentos no pueden enviarse a una API de terceros, o hay millones de páginas y pagar por cada una sale caro, los equipos ajustan un modelo multimodal abierto y lo ejecutan por su cuenta. Para eso hacen falta los mismos pares de foto y texto.
- Para cubrir los puntos débiles. Escrituras poco comunes, letra desordenada, formularios propios de tu sector: los modelos universales fallan sobre todo justo donde hay pocos datos en internet.
La conclusión práctica: aunque no pienses entrenar nada, un conjunto de prueba con documentos reales es la única forma de saber si puedes confiar en el modelo elegido para totales, fechas y nombres.
Cómo redactar una tarea de recopilación de datos para OCR
El formato más eficiente es una sola tarea en dos partes: una persona fotografía un documento y luego escribe su texto. Así obtienes un par "imagen más texto de referencia" en un solo paso. Una buena tarea especifica:
- Qué fotografiar exactamente. "Tu propio recibo de supermercado del último mes" funciona mejor que "cualquier recibo".
- Condiciones de captura. Condiciones distintas para campañas distintas: plano sobre una mesa, en ángulo, con poca luz, un documento arrugado. Así controlas la composición del dataset en lugar de dejarla al azar.
- Cuántos archivos por tarea. Por ejemplo, cinco recibos distintos. No tomes más de cinco a diez de una misma persona: compra en las mismas tiendas, usa el mismo móvil y hace las fotos en la misma cocina.
- Reglas de transcripción. Línea por línea, caracteres y dígitos exactamente como están impresos, sin corregir erratas ni abreviaturas. Un fragmento ilegible se marca con una etiqueta como [?], no se adivina.
- Reglas sobre datos personales. Qué tapar antes de hacer la foto y cómo marcar las partes tapadas en la transcripción.
- Un ejemplo bueno y uno malo. Una foto con una transcripción correcta y otra con errores típicos.
Ejemplo de tarea: "Fotografía 5 recibos distintos tuyos de tiendas o cafeterías del último mes. Coloca cada recibo sobre una superficie normal y haz la foto a mano alzada, sin alinearlo a la perfección. Antes de la foto, tapa con un trozo de papel el número de tarjeta, tu nombre y tu número de teléfono, si aparecen. Para cada recibo, escribe todo el texto línea por línea exactamente como está impreso; marca las partes tapadas como [HIDDEN] y las ilegibles como [?]."
Consejo: en documentos largos, divide la captura y la transcripción en dos tareas. Cuando alguien tiene que escribir una página de letra pequeña, empieza a saltarse líneas hacia el final, y ese tipo de trabajo necesita otra tarifa.
Transcripción y anotación: qué nivel de detalle necesitas
La anotación que necesitas además de la foto depende de la función del modelo. Cuanto más detallada es la anotación, más cuesta y más importante es verificarla:
Nivel | Qué hace la persona | Para qué sirve |
|---|---|---|
Texto del documento completo | Escribe el texto línea por línea | Evaluar y ajustar modelos de imagen a texto |
Campos clave | Introduce la fecha, el total y el comercio en un formulario | Extraer datos de recibos y facturas |
Líneas y palabras con recuadros | Dibuja un recuadro alrededor de cada línea o palabra y etiqueta su texto | Entrenar detectores de texto y pipelines de OCR clásicos |
Estructura del documento | Relaciona campos con valores, anota tablas | Comprensión de formularios, como en FUNSD |
Los dos primeros niveles se dividen bien en microtareas y pueden hacerse directamente desde el móvil. Los recuadros y la estructura requieren una herramienta de anotación y formación, y suelen hacerse en una etapa aparte. Escribimos sobre cómo organizar ese tipo de anotación mediante outsourcing en nuestro artículo sobre outsourcing del etiquetado de datos.
Datos personales en documentos: qué se puede recopilar y qué no
Los documentos reales casi siempre contienen información personal, y esa es la principal limitación en la recopilación de datos para OCR. Las reglas de trabajo son:
- Solo documentos propios. Los participantes fotografían sus propios recibos y papeles, no los de otras personas.
- Tapar los datos personales antes de la foto. Nombres, direcciones, números de teléfono y de tarjeta se tapan con un trozo de papel o se difuminan. Los envíos con datos personales que no pediste se rechazan.
- Nada de documentos de identidad ni bancarios. Pasaportes, documentos de identidad, extractos bancarios y tarjetas de pago no se recopilan en absoluto a través de una plataforma abierta.
- Formularios de plantilla con datos ficticios. Subes un formulario en blanco y el participante lo imprime o lo copia y lo rellena a mano con datos inventados. Es la forma más segura de obtener muestras de escritura a mano y formularios de tu propio tipo.
Advertencia: que los participantes tapen los datos personales no es una garantía. Antes del entrenamiento, pasa las transcripciones por una detección de nombres, números de teléfono y números de tarjeta, y elimina o difumina tú mismo las fotos dudosas. Si el corpus se va a usar en la UE u otras jurisdicciones con leyes estrictas, consulta los requisitos con un abogado.
Control de calidad: fotos, transcripciones y falsificaciones
La recopilación para OCR tiene dos fuentes de error: una mala foto y una transcripción inexacta. La segunda es más peligrosa: el modelo la tomará como la verdad de referencia, y la métrica de calidad de tu conjunto de prueba se medirá contra la respuesta equivocada. Qué revisar:
- Que la foto y el texto coincidan. Una línea del recibo omitida o dígitos intercambiados se ven al comparar, incluso en una muestra.
- Una segunda revisión por otro participante. Una tarea aparte: comparar la transcripción de otra persona con la foto y señalar los errores. Para el conjunto de prueba, es casi obligatorio.
- Un modelo existente como filtro. Si una transcripción difiere mucho de lo que lee un OCR estándar en una buena foto, revísala a mano. Pero no la rechaces automáticamente: a veces el que se equivoca es el modelo.
- Falsificaciones. Una foto de una pantalla en lugar de papel, una imagen de internet, el mismo recibo fotografiado desde distintos ángulos. La búsqueda inversa de imágenes, la detección de casi duplicados dentro del conjunto y los metadatos de los archivos ayudan a detectar muchas de ellas.
Comprueba la variedad del dataset con metadatos, no con intuición: país, tipo de documento, condiciones de captura, un ID anónimo del participante. Este último también es necesario para una división limpia entre entrenamiento y prueba: todos los documentos de una persona deben ir a la misma parte. Para saber más sobre cómo la diversidad de participantes hace un dataset más robusto, consulta nuestro artículo sobre cómo crear datasets diversos.
Recopilación de datos para OCR en RapidWorkers: proceso y coste
En RapidWorkers hay más de 195,000 trabajadores registrados de más de 200 países, así que puedes recopilar documentos en cualquier escritura que se use en los países que elijas: latina, cirílica, árabe, devanagari, caracteres chinos, tailandesa, bengalí y otras. Creas una tarea de recopilación de imágenes, especificas qué fotografiar y cómo transcribirlo, y fijas el número de archivos por envío. Cada trabajador puede completar una tarea solo una vez. Encontrarás los detalles en la página de recopilación de datos para OCR.
El empleador fija la tarifa por tarea, y se añade una comisión del 15% encima. El depósito mínimo es de $20, la campaña mínima es de $0.30 y los envíos rechazados no se pagan. Una transcripción larga cuesta más que una corta. Aquí tienes ejemplos con tarifas ilustrativas:
Qué recopilas | Tareas y tarifa | Tareas | Comisión del 15% | Total |
|---|---|---|---|---|
Piloto: 1 recibo con transcripción, ~4 min | 20 × $0.50 | $10.00 | $1.50 | $11.50 |
200 participantes con 5 recibos transcritos cada uno (1,000 fotos), ~15 min | 200 × $2.25 | $450.00 | $67.50 | $517.50 |
Formulario de plantilla manuscrito de 300 personas distintas, ~10 min | 300 × $1.50 | $450.00 | $67.50 | $517.50 |
Segunda revisión de las transcripciones de recibos, ~2 min por recibo | 1,000 × $0.30 | $300.00 | $45.00 | $345.00 |
Las tarifas de la tabla suponen aproximadamente $7–9 por hora de tiempo real de trabajo. La transcripción es un trabajo minucioso, y con una tarifa demasiado baja la gente empieza a saltarse líneas y a redondear números, que son justo los errores que luego aprenderá tu modelo. Mide el tiempo real de la tarea en tu piloto y ajusta la tarifa en consecuencia. Los formularios manuscritos te dan lo que les falta a los datasets públicos: cientos de estilos de letra distintos en tu propia plantilla, sin un solo nombre real en los datos.
Preguntas frecuentes sobre datos de entrenamiento para OCR
¿Qué es un dataset de OCR?
Es un conjunto de imágenes que contienen texto, cada una emparejada con una transcripción exacta de ese texto. A veces también incluye recuadros alrededor de líneas y palabras o etiquetas de campos clave, como la fecha y el total de un recibo. Los modelos se entrenan y evalúan con estos pares.
¿Dónde conseguir datos de entrenamiento para OCR?
Los datasets públicos como SROIE, CORD, FUNSD e IAM sirven para empezar, si la licencia permite tu uso. Un producto necesita sus propios datos: fotos reales de tus tipos de documento, en los idiomas adecuados y en condiciones de captura reales. Los equipos los recopilan a través de plataformas de crowdsourcing o de socios.
¿Cuántas imágenes se necesitan para entrenar un modelo de OCR?
Para hacer ajuste fino de un modelo existente con un tipo de documento, los equipos suelen empezar con entre unos cientos y mil ejemplos; como comparación, la parte pública de CORD tiene 800 recibos de entrenamiento. Una nueva escritura o la letra manuscrita requieren bastantes más, y en la escritura a mano importa la cantidad de personas distintas. Empieza por el conjunto de prueba.
¿Se puede entrenar un OCR solo con datos sintéticos?
Los datos sintéticos, es decir, texto generado sobre imágenes con distorsiones, funcionan bien para el preentrenamiento y para añadir volumen. Pero el conjunto de prueba debe estar formado por fotos reales, o no sabrás cómo se comporta el modelo con el papel térmico, los reflejos y la escritura a mano real.
¿Cómo recopilar recibos y formularios sin vulnerar la privacidad?
Los participantes fotografían solo sus propios documentos y tapan nombres, direcciones, números de teléfono y de tarjeta antes de hacer la foto. No se recopilan documentos de identidad ni bancarios. Para los formularios, la vía más segura son plantillas en blanco rellenadas con datos ficticios.
Qué hace que un dataset de OCR sea útil para un producto
Los datasets públicos enseñan a un modelo a leer escaneos limpios, mientras que tu producto necesita que lea lo que la gente envía de verdad. Un buen dataset de OCR se apoya en cuatro cosas: fotos reales en condiciones de captura variadas, documentos de los países y en los idiomas donde opera tu producto, transcripciones precisas con una segunda revisión y reglas claras sobre datos personales. Empieza con un conjunto de prueba de unos cientos de fotos reales: te mostrará dónde falla tu modelo y, a partir de ahí, podrás recopilar datos de forma dirigida.
Si necesitas recibos, formularios o muestras de escritura a mano de países concretos, lanza una campaña piloto en RapidWorkers. Tratamos el proceso general de recopilación de datos para IA en nuestra guía de recopilación de datos de entrenamiento para IA.
¿Listo para empezar?
Únete a miles de trabajadores y empleadores que ya usan RapidWorkers para completar tareas rápido.
- Sin suscripción
- Cancela cuando quieras
- Disponible 24/7
- Resolución de disputas